大约 1 年前
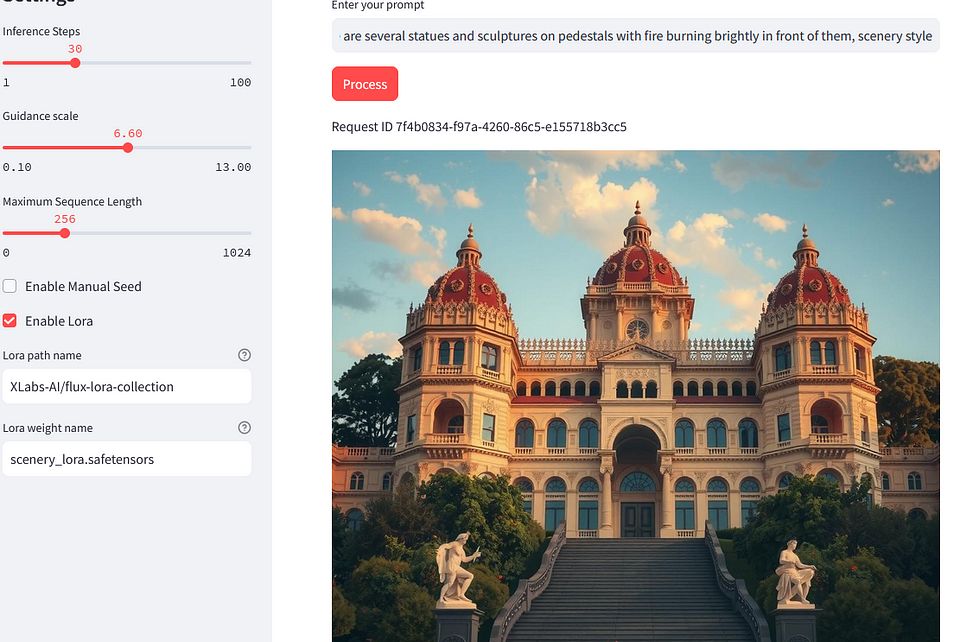
汽车维修店,欧美卡通风格,游戏场景,45°固定视角,色彩鲜艳,内容丰富
本文介绍了如何利用无服务器基础设施(如Modal)运行开源生成AI模型,特别是最新的文本到图像模型Flux。作者通过创建API端点和使用Streamlit构建简单前端,展示了如何在Modal平台上进行模型推理。文章还提到了Modal提供的按需GPU服务,价格低廉,适合个人开发者使用,并提供了详细的代码示例和教程。
FLUX.1 dev和schnell开源文本到图像生成模型提供了卓越的质量,但运行FLUX.1 dev需要16-24GB的VRAM。量化模型通过压缩全尺寸模型,降低了VRAM需求,但可能牺牲一些准确性。用户需下载适当的量化模型并在ComfyUI中安装自定义节点,设置工作流程以确保模型正常运行。FLUX相较于以往模型在遵循提示方面表现更佳。
本文介绍了两种生成图像的模型:Stable Diffusion XL和Flux。Stable Diffusion XL易于安装,配有简单的Web UI,名为Fooocus。Flux则能生成高质量的文本图像,但安装较为复杂。文章详细描述了Flux的安装步骤,包括下载模型、配置和运行。此外,还提到了Yacana,一个用于本地开源LLMs的多代理框架,适合创建LLM驱动的应用。最后,作者鼓励读者尝试生成图像,并提供了一些建议和帮助。
最近我使用Flux的托管版本生成图像,但费用很高。于是我决定使用gguf格式在本地生成图像,这种格式使模型更紧凑、加载更快。整个过程分为四部分:下载并运行ComfyUI、下载工作流程、下载模型、编写提示并运行工作流程。需要下载ComfyUI和相关模型,并在ComfyUI中加载它们。最终可以在浏览器中查看生成的图像和控制器。
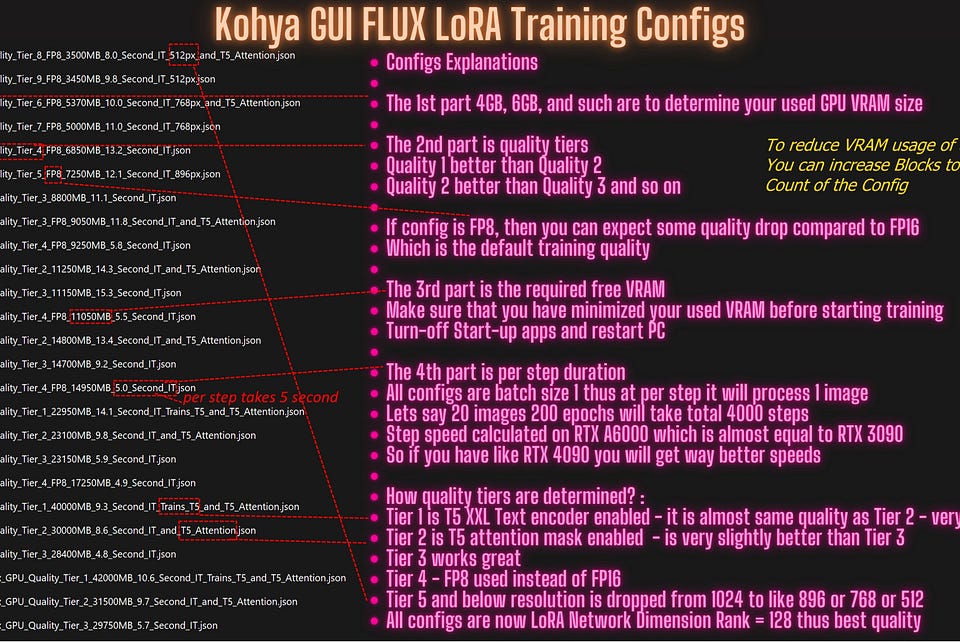
Kohya对FLUX LoRA和DreamBooth进行改进,使得最低4GB的GPU也能进行FLUX LoRA训练,6GB以上GPU可进行全方位微调。更新后,30GB以上模型下载仅需1分钟,并支持LoRAs的快速块交换。FP16训练现已适用于24GB及以下的GPU,关键在于FP8、块交换和特定层的训练。完整的微调和LoRA训练教程可在线查看。
© 2026. All Rights Reserved